大语言模型的预训练[3]之Prompt Learning:Prompt Engineering
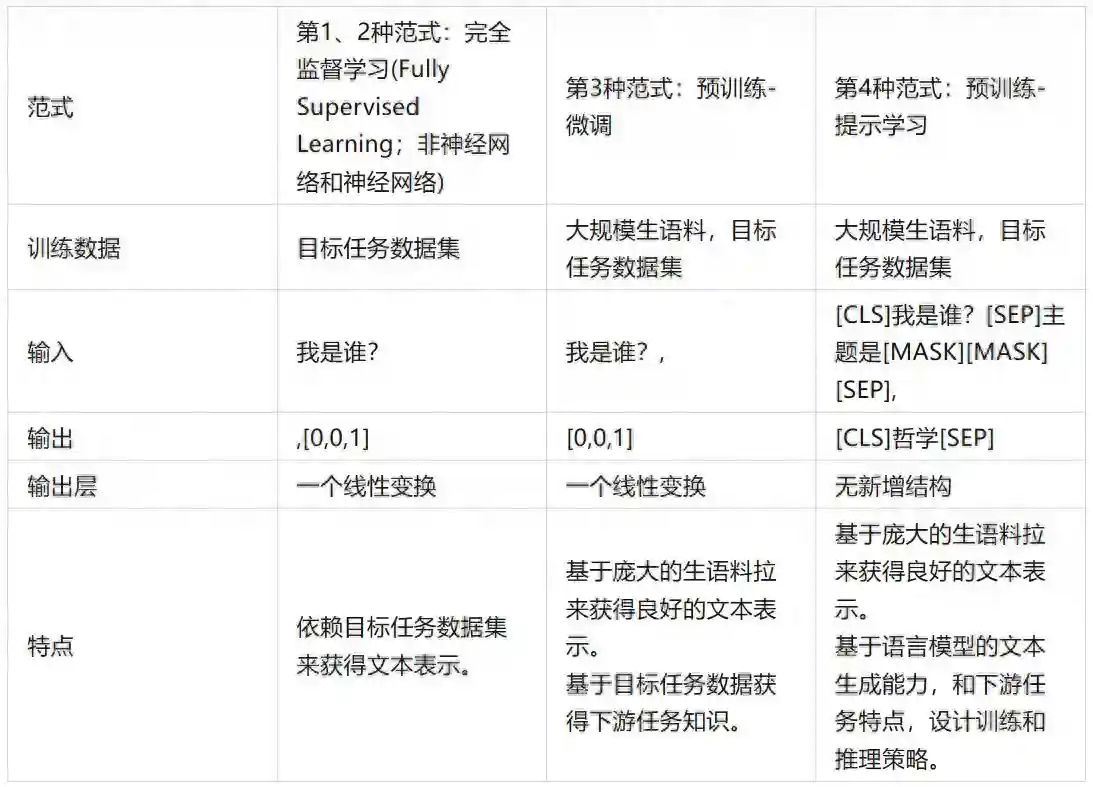
目前学术界一般将NLP任务的发展分为四个阶段,即NLP四范式::
第一范式:传统机器学习模型的范式,基于全监督学习(fullysupervisedlearning)的方法。通过构建特征工程(featureengineering),利用领域知识从数据中提取好的特征,直接解决下游任务。例如tf-idf特征+朴素贝叶斯等机器算法。
第二范式:基于深度学习模型的范式,通过设计结构工程(architectureengineering),即设计一个合适的网络结构来把归纳偏置(inductivebias)引入模型中,训练一个端到端的模型,利用学习好的特征,直接解决下游任务。例如word2vec特征+LSTM等深度学习算法,相比于传统方法,模型准确有所提高,特征工程的工作也有所减少。
第三范式:基于预训练模型+finetuning的范式,即预训练+微调(pre-trainandfine-tune)。在这个模式中,先用一个固定的结构预训练一个语言模型(languagemodel,LM),预训练的方式就是让模型补全上下文(比如完形填空)。相比于深度学习模型,模型准确度显著提高,模型也随之变得更大,小数据集也可以训练出效果好的模型。
第四范式:基于预训练模型+Prompt+预测的范式,跟第三范式一样,先获得大型语言模型,然后通过引入额外的参数或微调来适应到下游任务上。这就逐渐形成了目标工程(objectiveengineering),即为预训练任务和微调任务设计更好的目标函数。如BERT+Prompt的范式相比于第三范式,模型训练所需的训练数据显著减少。
NLP四个范式对比如下所示:
PromptLearning就是期望预训练语言模型在下游任务中,在不显著改变预训练语言模型结构和参数的情况下,通过向模型输入增加“提示信息”,只需要模型本身就能够解决问题。即通过为输入内容添加额外的文本(重新定义任务)的方式,来更好的挖掘预训练语言模型本身能力的一种方法。
传统的监督学习任务,是去训练一个模型P(y|x),接收x作为输入,去预测y。Promptlearning是依赖于预训练语言模型P(x),通过引入合适的模版将输入x调整为完形填空格式的x’,调整后的输入x’里含有空槽,利用语言模型P将空槽填充后就可以推断出对应的y。例如,对于情感分析任务,传统的做法就是训练一个判别模型,去预测输入x对应的标签是positive或者negative,但是如果是promptlearning,则是利用合适模版,将输入x调整为[x],itis[z]。然后作为语言模型的输入去预测相应z的取值,如果z是positive相关的词,就表示原始输入x是positive,反之就是negative的。
Promptaddition
选择合适的模版,定义函数fprompt(x),可以将原始的输入x转化为x‘,即fprompt(x)=x’。经过该函数转化得到的输入都是带有空槽,这个位置一般在句中或者句末,位置以及数量都可能对结果造成影响,需要人工构造,空槽上的预测值会直接决定最后的结果。
模板是:【X】Overall,itwasa【Z】course。
【Z】在句中,这种prompt称为clozeprompt。如果在句末,则这种prompt称为prefixprompt。
另外,这里的模版不仅仅可以是离散化的token,也可以连续的向量。在不同的下游任务,可以灵活调整,选择合适的模版。
Answersearch
Answersearch指的是从所有可能的候选槽值进行搜索,然后选择合适的槽值填充到对应的空槽里。这里槽值的所有可能结果的集合为Z,对于生成任务而言,Z包括所有的token,但是对于分类任务而言,Z只包含跟特定分类任务相关的一部分token。例如对于之前那个例子而言,Z={positive相关的词语,negative相关的词语}
Answermapping
当通过answersearch得到合适的槽值时,需要根据槽值推断最终的预测结果。这部分比较直接,假如是生成任务,那么填充的槽值就是最终的结果。但如果是分类任务,就需要根据相应的槽值归纳到具体的类中。例如情感分类中,如果把跟positive相关的槽值都归类到positive一类,把跟negative相关的槽值归类到negative一类中。
PromptEngineering的核心思想,主要就是将已有的下游NLP任务重构成token级的预测任务,在不改变原有的pre-trainedLM的前提下(也就是说不进行finetuning)直接将LM应用的过程,换言之,是在用下游任务适配LM。融入了Prompt的模式大致可以归纳成“Pre-train,Prompt,andPredict”,在该模式中下游任务被重新调整成类似预训练任务的形式。
1.3PromptLearning的方法在了解promptlearning的基本组成后,有以下几个方面都会影响promptlearning的最终效果。
Promptengineering,设计合适的模版函数,是整个promptlearning的第一个步。
预训练语言模型的选择,预测空槽位置上的答案依赖于预训练语言模型的得分,同时预训练语言模型又有4大类。
Answerengineering,构建一个合适的答案候选集以及一个从答案到最终结果的映射。
Expandingtheparadigm,基于基础的promptlearning去扩展,包括multiprompt等。
Trainingstrategy,选择训练策略,去训练一个合适的模型。
1.4PromptengineeringPromptengineering是创建prompting函数$fprompt(x)$的过程,即构建一个合适的模版函数,使下游任务能取得最高效的表现。Promptlearning利用预训练语言模型去预测最终结果,那么如何将输入x转化为语言模型擅长处理的样式就是Promptengineering的工作。一个不合适的promptfunction会导致语言模型不能做出令人满意的预测。
根据【Y】的位置Prompshape可以分为填充文字字符串空白的完形填空(clozeprompt)和用于延续字符串前缀的前缀(prefixprompt)。
对于有关生成任务或使用标准自回归LM解决的任务,使用prefixprompt,因为与模型从左到右的性质吻合。PS:“I'mnotsureIunderstandthispoint。Pleasecontinuetowrite:【Y】”
对于使用掩码(Mask)LM解决的任务(),clozeprompt更合适,因为与预训练任务的形式匹配。PS:“【Y】course“
为了最终任务的效果,需要根据语言模型和下游任务的特性,去构建合理的prompt。构建prompt方式有三种:
1)人工构建
Promptlearning最直接的方式是通过专业人士的经验知识构建合理的prompt,给模型增加合适的提示。通过人工构建的prompt,由于附带人的专业知识,非常直观理解,过程简单,效果相对可控,可供快速尝试。能支持强大预训练模型实现fewshot甚至zeroshot,媲美那些有监督学习的方法。同时,人工构建prompt的方式有很广泛的应用,可以直接去支持下游任务,也可以辅助半监督学习方法去构建数据集,做数据增强等等。人工构建prompt的方式,作为一种简单有效的方式,也验证了promptlearning的价值,减轻了对有监督数据的依赖,提供了一个将庞大的预训练模型应用到众多下游任务的方向。
虽然这种方式直观,但是人工构建prompt的方式有两个弊端,一方面人工构建prompt和测试prompt效果耗费时间跟精力,另一方面是即便是专业人士也不一定能通过人工的方式构建最优的prompt。为了解决这个问题,自然而然就衍生自动构建prompt的方式,自动构建prompt可以分为离散型的prompt(prompt可以用具体的字符表示)和连续型的prompt(prompt由向量替代)。
2)离散型prompt
离散Prompts指的是自动生成由自然语言的词组成的Prompt,因此其搜索空间是离散的。通常是先由人工构建,然后可以通过种子prompt去扩充,也可以通过生成方式去获取。在构建得到prompt候选集后,可以在下游任务上评估,也可以通过语言模型去打分。最终可以只选择最合适的一种prompt,也可以集成多个prompt。离散的主要包括PromptMining,PromptParaphrasing,Gradient-basedSearch,PromptGeneration和PromptScoring。
PromptMining.该方法需要一个大的文本库支持,例如Wikipedia。给定输入x和输出y,要找到x和y之间的中间词或者依赖路径,然后选取出现频繁的中间词或依赖路径作为模板,即“[X]middlewords[Z]”。
方法是基于释义的,主要采用现有的种子prompts(例如手动构造),并将其转述成一组其他候选prompts,然后选择一个在目标任务上达到最好效果的。一般的做法有:将提示符翻译成另一种语言,然后再翻译回来;使用同义或近义短语来替换等。
Gradient-basedSearch.梯度下降搜索的方法是在单词候选集里选择词并组合成prompt,利用梯度下降的方式不断尝试组合,从而达到让PLM生成需要的词的目的。
PromptGeneration.既然Prompt也是一段文本,那是否可以用文本生成的方式来生成Prompt呢?该类方法就是将标准的自然语言生成的模型用于生成prompts了。例如,Gao等人将T5引入了模板搜索的过程,让T5生成模板词;Ben-David等人提出了一种域自适应算法,训练T5为每个输入生成一种唯一的域相关特征,然后把输入和特征连接起来组成模板再用到下游任务中。
等人在研究知识图谱补全任务的时候为三元组输入(头实体,关系,尾实体)设计了一种模板。首先人工制造一组模板候选,然后把相应的[X]和[Z]都填上成为prompts,并使用一个双向LM给这些prompts打分,最后选取其中的高分prompt。
3)连续型prompt
构造Prompt的初衷是能够找到一个合适的方法让Pre-trainedLanguageModel(PLM)更好地输出我们想要的结果,但其实并不一定要将Prompt的形式设计成人类可以理解的自然语言,只要机器理解就行了。连续性prompt可以摆脱人类理解的自然语言,直接作用到模型的Embedding空间,通过梯度更新优化。由于可以进行梯度优化,它的效果通常优于离散型prompt,而离散型prompt由于不可导只能采用近似梯度或其他方式去优化。
连续型prompt的初始化很重要,一般会采用合理的token进行初始化,这些token可以是手工设计的离散型prompt。模版中词语的Embedding可以是整个自然语言的Embedding,不再只是有限的一些Embedding模版的参数不再直接取PLM的参数,而是有自己独立的参数,可以通过下游任务的训练数据进行调整。
连续Prompts相比于离散Prompts来说不再拘泥于人类可以理解的语言,会将机器可以理解的向量embedding也作为Prompt模板。目前的连续prompts方法大致可以分为下面三种:
PrefixTuning.在输入前添加一串连续的向量的方法,该方法保持PLM的参数不动,仅训练合适的前缀(prefix)。freeze预训练参数,单纯调参每一层前缀提示向量参数。它的形式化定义是,在给定一个可训练的前缀矩阵Mφ和一个固定的参数化为θ的PLM的对数似然目标上进行优化,即:maxϕlogP(y∣x;θ;ϕ)=maxϕΣyilogP(yi∣hi;θ;ϕ)其中hi=[hi(1);;hi(n)]指的是所有神经网络层在第i个时间步的连接。如果对应的时间步在前缀中,即hiisMϕ[i],则它可以直接从前缀矩阵中复制过来;否则需要使用PLM进行计算。类似地,输入序列前面加上特殊的token来组成一个模板,然后直接调整这些token的embedding。和上面的PrefixTuning的方法相比,他们的方法相对来说参数较少,因为没有在每一层网络中引入额外的参数。
TuingInitializedwithDiscretePrompts.这类方法中连续prompts是用已有的prompts初始化的,已有的prompts可以是手工设计的,也可以是之前搜索发现的离散prompts。先用一个离散prompt搜索方法定义了一个模板,然后基于该模板初始化虚拟的token,最后微调这些token的embedding以提高准确率。
Hard-SoftPromptHybridTuning.这类方法可以说是手工设计和自动学习的结合,它通常不单纯使用可学习的prompt模板,而是在手工设计的模板中插入一些可学习的embedding。Liu等人提出了“P-Tuning”方法,通过在inputembedding中插入可训练的变量来学习连续的prompts。并且,该方法使用BiLSTM的输出来表示promptembeddings,以便让prompttokens之间有一定的交互。P-tuning还引入了任务相关的anchortokens(例如关系提取中的“capital”)来进一步提高效果,这些anchortokens不参与后续的调优。Han等人提出了PromptTunningwithRules(PTR)方法,使用手工指定的子模板按照逻辑规则组装成完整的模板。为了增强生成的模板的表示能力,该方法还插入了几个虚拟token,这些虚拟token的embeddings可以和PLM的参数一起被调整,PTR的模板token既有实际token也有虚拟token。实验结果证明了该方法在关系分类任务中的有效性。
2.预训练语言模型的选择Left-to-RightLM:GPT,GPT-2,GPT-3
MaskedLM:BERT,RoBERTa
PrefixLM:UniLM1,UniLM2
Encoder-Decoder:T5,MASS,BART
3.AnswerengineeringAnswerengineering旨在寻找一个合适的答案空间Z以及一个从答案到最终输入y的一个映射,从而得到一个有效的预测模型。Promptlearning之所以能实现fewshot甚至zeroshot,是依仗于预训练语言模型强大的泛化能力。但是语言模型在预测时都是针对全词表的,对于下游任务而言并不一定需要全词表的,例如情感分析任务下如果预测到人称代词时要怎么推断最终结果的情绪呢?为此,Answerengineering要去寻找一个跟下游任务匹配的答案空间,也就是构建候选集,并定义好答案空间到最终输出之间的映射,候选词跟最终输出的对应关系。
Answer的形式决定了它的任务,常见的选择包括:
Token:预训练LM词汇表中的一个token,或者词汇子集;
Span:短的multi-tokenspan,这些通常与clozeprompt一起使用;
句子或文档:通常与前缀prompt一起使用。
Token跟Span的情形多见于分类相关任务,句子或文档多见于生成相关任务。答案空间同样可以通过人工构建,也可以通过模型去搜索查找。大部分的方法构造的候选集都是离散化的,只有很少部分方法是连续化的。与promptengineering相同,answerengineering同样有人工设计与自动获取两种方法。
人工设计答案:人工设计分为两类空间。Unconstrainedspaces中的空间包含了输出空间的所有结果,token级的话则是全部词表中的词(比如W2V的输出层),其余类型相同。这类方法可以直接找到Z与y的映射关系。Constrainedspaces,这类方法通常输出是在一个限定范围内(比如positive和negative),这类方法就需要一个映射关系来映射Z与y。特点:直观,自然,费力,经验。
自动学习答案:人工设计answer的方式最终很有可能在获得一个次最优的语言模型,通过人工设计answer的方式依旧依赖于专业人士的知识,不容易迁移到更多场景。基于此,出现了一些自动设计answer的工作。
1)Answerparaphrasing:首先初始化一个答案空间然后用这些答案的释义去扩充答案空间直至收敛。这种扩充answer的方式可以理解为单个的答案候选可能不太稳定,如果语言模型对它理解不到位会导致最后结果偏差较大,所以通过回译的方式扩充答案空间从而获得每个类别的多个候选表达,综合考虑模型对多个候选表达的预测结果会得到更加鲁棒的结果。最终实验也证明了通过这种方式得到的多样化的表示可以有效提高语言模型在多选QA问题的表现。
2)Prune-then-search:先对答案候选空间进行裁剪,然后再通过算法去搜索得到最终合适的答案候选。
3)LabelDecomposition:由于类别标签已经包含了很多真实的语义信息,所以Adaprompt直接将类别标签分解为多个token作为该类别的候选答案,例如一个类别是”per:cityofdeath”,把这里一些没有语义的连接词(例如of)去掉后,从而得到对应的候选答案是{person,city,death}。
4)连续型答案自动搜索:这类工作较有代表性的WRAP在词嵌入部分为每个类别指定了一个连续的变量去表征这个类别,然后通过梯度回传去更新这个表征类别的词嵌入。
4.Multi-promptlearning以上的prompt工程方法主要集中于为输入构建单个prompt。相对于单个prompt,多个prompt往往能提高promptingmethods的有效性。常见的多个prompt的方法有以下几种类型。
a)Ensemble
多个prompt,每个prompt都按照单prompt的方法并行进行,然后再把最终的结果汇总,可以通过加权或者投票的方式汇总多个单prompt的方法的结果。
可以利用不同prompt的优势实现互补。
可以缓解promptengineering中寻找一个最优prompt的繁重工作。
可以在下游任务表现得更加稳定。
b)Augmentation
又称为模仿学习,它的思路跟GPT2的fewshot做法极为相似,就是给出一些完整的样例([MASK]位置被正确预测了的完形填空格式,也称answeredprompt),跟当前的完形填空格式一同输入语言模型,这样语言模型就会按照完整的样例,举一反三,对当前问题的[MASK]位置做出更加准确的预测。增强的方式其实就是找一个跟当前问题相似的case,然后将这个case跟当前输入x‘一起输入,这种模型就可以根据那个case对x‘做出更精准的预测了。
c)Composition
所有可组合的语言任务可以由多个基本的子任务组成,promptcomposition利用多个子prompt构建prompt函数,每个子prompt针对一个子任务,把多个prompt的内容融合到一起,可以定义更加复杂的prompt,同时进行多个子任务的预测。例如关系抽取任务,有的prompt负责实体识别,有的prompt负责判断实体间的关系。
d)Decomposition
跟promptcomposition刚好反过来,对于有些问题,想通过定义一个完整的prompt去解决会非常具有挑战,于是一个直观的做法就是将这个问题分解为多个问题,分别定义多个子prompt去分别处理。例如命名实体问题,可以将文本划分为多个片段,然后用各个子prompt分别去识别这些片段是否是实体或者对应的是实体类型,最后汇总所有片段的结果即可。promptcomposition跟promptdecomposition都是需要明确问题是由哪些子任务组成的,设计完相应的子prompt后再根据具体场景决定是用分解还是组合的方式解决。
5.Trainingstrategy在大部分情况下,promptlearning可以在不经过任何语言模型的显示训练下直接应用到下游任务中。如同典型的zeroshot,通过跟下游任务相关的prompt,将原始文本转化为带[MASK]标记的完形填空问题,用语言模型直接去预测[MASK]位置的token。整个过程不涉及训练,也不需要另外的训练数据。
然而,有一定训练数据的加持能进一步提升模型的效果,所以也衍生跟promptlearning相关的一些训练策略,尤其是对于fewshotlearning,加入一点点相关训练数据的训练可以驱使模型往正确的方向演变,从而更加有效。对于promptlearning相关的方法一般有两部分参数,一部分是预训练语言模型自身的参数,另一部分是跟prompt相关的参数,那类参数应该更新是一项重要的设计决策。
研究者基于底层语言模型的参数是否需要调整、是否有额外的prompt参数和这些额外的prompt参数是否需要调整这三个方面总结以下调整策略,把可能的参数更新方法分为5种类型。
a)Promptfine-tuning
首先乱入的是跟promptlearning没有任何关系的方法,也是常见的finetune,这种类型的方法不涉及prompt,不需要prompt相关设计,也没有prompt相关的参数。这种类型的方法最大的短板在于对训练数据量有一定要求,这就限制了它在低资源场景下的广泛应用。
优势:简单,不需要另外设计prompt,直接在训练数据上调整语言模型的参数即可。
劣势:训练数据不足时容易过拟合或者不稳定。
b)Tuning-freePrompting
这种类型的方法其实就是GPT中的zeroshot,不需要训练数据,没有训练过程,基于prompt直接生成答案,无需调参。之前提及的离散型prompt自动构建或者人工构建prompt的方法多属于这种类型。
优势:高效,不需要参数更新过程,固定语言模型参数,可以在下游任务直接zeroshot。
劣势:需要准确的prompt设计。
c)Fixed_LMPromptTuning
引进了额外的跟prompt相关的的参数,通过固定语言模型参数,去微调跟prompt相关的参数,使下游任务更好作用于prompt的产生。之前介绍过的连续型prompt的自动构造相关的方法基本都属于这种类型。
优势:适合小样本学习,跟tuning-freeprompting类似,能够保留语言模型的知识,并且适用于fewshot场景,效果也会比tuning-freeprompting好。
劣势:不适用于零样本学习,promptengineering相关工作很重要,微调得到的prompt也基本不是人能理解和掌握的。
d)Fixed-promptLMTuning
跟Fixed-LMPromptTuning相反,同样会引入额外的跟prompt相关的参数,但是会固定跟prompt相关的参数,只微调语言模型自身的参数。如果使用离散型prompt并据此进一步优化语言模型参数的话就属于这种类型的方法。
优势:promptengineering跟answerengineering更完整的说明了任务,更适用于fewshot场景。
劣势:严重依赖于promptengineering和answerengineering的效果,最终效果可能不及没有使用prompt的方法。
e)Prompt+LMTuning
Prompt相关参数跟语言模型自身参数都进行微调,跟常规的预训练语言模型微调很像,新增的prompt可以在模型的训练开始时提供一种增强策略,适合大数据集,小数据集易过拟合。
优势:最具表达能力的模型,适用于有充足数据的场景。
劣势:需要一定的训练,对数据量有一定要求,需要存储所有模型的参数,包括语言模型自身的参数和跟prompt相关的参数。
在训练条件充足的条件下,promptlearning相对于常规的finetune没有明显优势,promptlearning的价值还是体现在fewshot甚至zeroshot场景下。同时可以看到对于不微调prompt相关参数的方法,模型效果都严重依赖于promptengineering和answerengineering。对于那些可以微调prompt相关参数的方法,又对于训练数据量有一定要求,如果连语言模型的参数也要调整的话,那么就需要更多的训练数据。所以对于fewshot场景,由于训练数据量限制,选择固定语言模型参数只微调prompt相关参数的方法更受青睐,对于每一个具体下游任务只需要保存prompt相关的参数即可,也为promptlearning的大范围应用提供了可能。
6.小结Promptlearning,充分利用了预训练语言模型强大的泛化能力,极大的减少了对下游任务有监督数据的依赖,能实现fewshot甚至zeroshot,对于当下数量众多的NLP下游任务,有很大的应用前景。但是关于如何构建prompt,如何选择语言模型,构建候选答案空间,构建答案到最终输出的映射,如何选择训练策略,如何寻找一个最佳配置使得下游任务效果达到最优,依旧是个需要持续探索的事情。Promptlearning是包括众多环节的一个学习任务,包括promptengineering,answerengineering,tuningstrategy,pretrainlanguagemodel,multipromptlearning等,每个环节都有若干种不同的选择,如何在如此繁多的可能性中搜索一个最优的组合确实是需要持续探索的事情。
6.1PromptLearning使得所有的NLP任务成为一个语言模型的问题PromptLearning可以将所有的任务归一化预训练语言模型的任务
避免了预训练和fine-tuning之间的gap,几乎所有NLP任务都可以直接使用,不需要训练数据。
在少样本的数据集上,能取得超过fine-tuning的效果。
使得所有的任务在方法上变得一致
6.2PromptLearning和Fine-tuning的范式区别Fine-tuning是使得预训练语言模型适配下游任务
Prompting是将下游任务进行任务重定义,使得其利用预训练语言模型的能力,即适配语言模型
6.3挑战与展望Prompt的设计问题。目前使用Prompt的工作大多集中育分类任务和生成任务,其它任务则较少,因为如何有效地将预训练任务和prompt联系起来还是一个值得探讨的问题。另外,模板和答案的联系也函待解决。模型的表现同时依赖于使用的模板和答案的转化,如何同时搜索或者学习出两者联合的最好效果仍然很具挑战性。
Prompt的理论分析和可解释性。尽管Prompt方法在很多情况下都取得了成功,但是目前prompt-basedlearning的理论分析和保证还很少,使得人们很难了解Prompt为什么能达到好的效果,又为什么在自然语言中意义相近的Prompt有时效果却相差很大。